Todo el que haya grabado en un cuarto pequeño conoce el problema del volumen: subes el fader de la voz porque no se entiende, y en el siguiente golpe de batería te arrepientes. En un home studio se arregla con un compresor y algo de paciencia. En el salón de tu casa, con una película en un 5.1 bajado a estéreo y una tele de altavoces enanos, el asunto se complica bastante más.
De todo esto va el Algoritmo Zainder, un trabajo que publiqué con DOI (https://doi.org/10.5281/zenodo.24437921) y que parte de una idea muy del oficio: no se trata de machacar la mezcla con un compresor, sino de tratar cada cosa como lo que es.
Del DAW al salón: el mismo diagnóstico, otro escenario
Si lo miras desde la mesa de mezclas, la escena doméstica presenta cuatro desastres conocidos:
- Pistas masterizadas con un rango dinámico enorme, pensadas para salas con un sistema calibrado.
- Un downmix agresivo en el que el canal central —donde vive la voz— se funde con música y efectos.
- Conos minúsculos que ni bajan ni reproducen limpio la franja de 1 a 4 kHz, que es donde se distinguen las consonantes.
- Y encima, cortes de nivel entre la película, la publicidad y el canal siguiente.
La bibliografía de inteligibilidad, la misma que se cita en producción de locuciones, deja una conclusión bastante clara: la relación señal-ruido se juega por bandas, no en el total. Empujar las bandas medias y altas de la voz rinde más que girar el pote de master hasta arriba.
Separar antes de procesar, el orden que importa
La mayoría de los presets “diálogo” de barras de sonido hacen EQ y compresión sobre la mezcla entera. Es lo rápido, y también lo que provoca el famoso bombeo: la voz sube, la música se aplasta con ella y cuando calla el narrador el fondo respira de golpe.
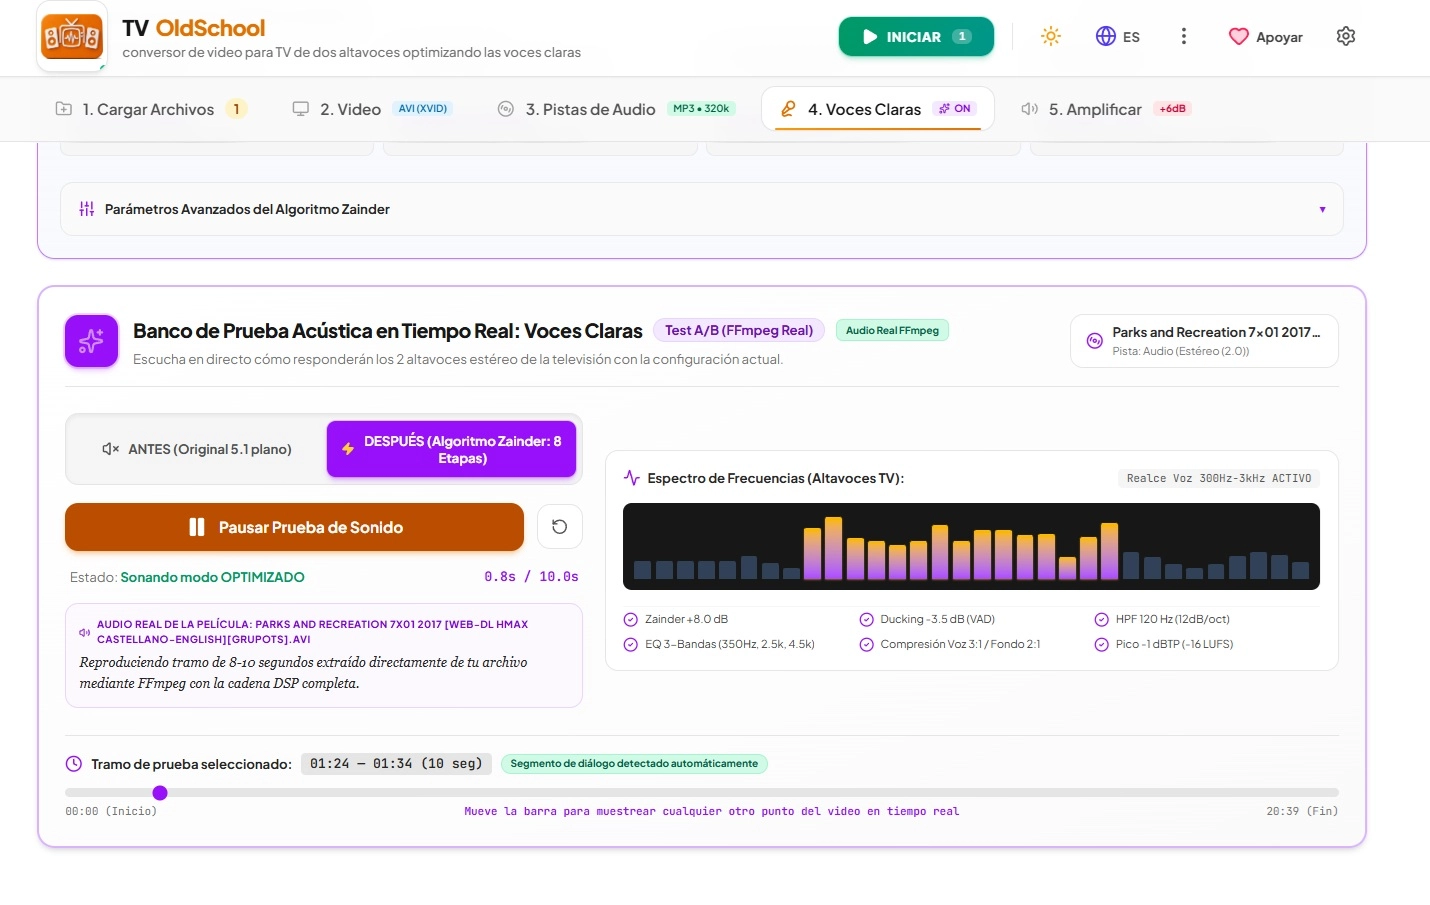
Zainder propone lo contrario. Primero separa la voz del resto; después somete a cada carril a su propio tratamiento, y solo al final los vuelve a juntar, dejando que el fondo se retire cuando alguien habla. El conjunto se resuelve dentro de un único grafo de FFmpeg por archivo, con salida estéreo. Para quien venga del audio, es como tener una cadena de insertos ya cableada: nada de botoncitos mágicos.
La cadena, etapa por etapa
- Separación de voz y fondo.
- Paso alto a 120 Hz en los dos carriles: la energía que el altavoz no va a reproducir solo se convierte en distorsión.
- Compresión asimétrica. La voz lleva ratio 1 + 2·i con ataque rápido; el fondo, 1 + i con tiempos más relajados. Con la intensidad por defecto (i = 0,67) eso deja 2,3:1 y 1,7:1.
- Ecualización centrada en la inteligibilidad, solo en la voz: −3 dB a 350 Hz para quitar el tono de caja, +4 dB a 2,5 kHz y +2 dB a 4,5 kHz para las consonantes.
- De-esser estático a 7 kHz y un exciter opcional. Son filtros de presencia, sin saturación ni armónicos de relleno.
- Rebalanceo y ducking por sidechain.
- Normalización de sonoridad con loudnorm.
- Limitador de picos con alimiter.
Todo se gobierna con un solo mando de intensidad, de 0 a 1, que reparte el trabajo entre el rebalanceo y la compresión. Ese detalle me parece fundamental: quien escucha decide cuánto se toca la mezcla original. Hay cosas que ganan inteligibilidad a costa de naturalidad, y no siempre compensa.
Cuatro rutas, y la honestidad de decir cuál separa de verdad
- Ruta A (5.1, 6.1 y 7.1): la voz se toma del canal central, que es voz real. Aquí hay separación auténtica.
- Ruta C (estéreo ligera): la voz sale de una versión limitada en banda del centro, y el fondo de una cancelación parcial (0,85·L − 0,35·R).
- Ruta B (espectral): filtrado por bandas, sin redes neuronales de por medio.
- Rama mono: sin información estéreo no hay milagro; solo énfasis espectral sobre dos copias de la misma señal.
En el paper lo dejo escrito sin adornos: solo la ruta A separa realmente. En el resto, lo que llamamos fondo es la propia mezcla filtrada. Eso se puede vender de mil maneras, pero es lo que hay.
El ducking: la parte que se lleva el mérito
Una copia de la voz, amplificada y filtrada en banda, manda sobre un compresor de cadena lateral aplicado al fondo. El fondo no baja una cantidad fija: cede en función de cuánto hay de voz. Con una señal de control a −20 dBFS, un ratio de 3,95 apunta a unos 12 dB de reducción teórica (cálculo analítico, sin rodilla ni tiempos de ataque y liberación). Cuando la voz aparece, el fondo se aparta; cuando calla, vuelve.
Para quien se haya peleado con un sidechain de bombo y bajo, la lógica es idéntica, solo que aquí la señal que gobierna es la voz y lo que se aparta es la banda sonora.
Niveles: una decisión tomada a propósito
Con la configuración por defecto la salida se queda sobre los −10 LUFS, bastante por encima de los −23 de la EBU R128. Es una elección para escucha doméstica con hardware flojo; la función Amplificación devuelve la salida al objetivo de −16 LUFS cuando hace falta.
Y un aviso que me costó medio día: el alimiter de FFmpeg, con el nivelado automático activado, reescala después de limitar y te devuelve el pico a 0 dBFS. Hay que ponerle level = 0 para respetar el techo. En una prueba sintética con pico de entrada de +3,5 dBFS, la salida quedó en −1,01 dBFS.
Lo que aún no está demostrado
La cadena se ha probado con señales sintéticas sobre FFmpeg 6.1.1: el grafo compila, se ejecuta sin error y respeta el techo. Lo que no hay todavía es validación con material real ni con oyentes. Todos los números son estimaciones sacadas de las fórmulas, salvo los que van marcados como medidos.
La ganancia nominal de la voz sobre el fondo ronda los +11 dB en la ruta A y los +19 dB en la ruta C con contenido centrado. Es una ganancia añadida, no una diferencia de sonoridad resultante, así que no se puede comparar tal cual con las recomendaciones de la literatura (10 a 15 LU de mínimo, 20 a 30 LU para mayores con voz sobre voz). Esa comparación llegará cuando haya medidas.
De ahí que el trabajo incluya un protocolo completo: STOI y SII como métricas objetivas, sonoridad y pico bajo BS.1770, y MUSHRA más pruebas de repetición de frases con ruido para el oído humano. También quedan documentadas 17 diferencias entre la idea inicial y lo que el código hace en realidad, además de un plan de evolución: separador neuronal de tres vías, loudnorm en dos pasadas, limitador de pico verdadero y normalización a la entrada.
¿Y lo del plugin VST?
Lo cuento como lo que es, una intención y no un producto. La cadena de Zainder está pensada en bloques y con parámetros acotados, así que el salto a un plugin —de tipo inserto o como efecto de bus para postproducción de vídeo— es razonable. La entrega actual, en cambio, es en diferido y para archivos: no toca señal en tiempo real.
Para quien quiera escucharlo, la implementación vive en TV Old School, una aplicación de escritorio que procesa el audio de un vídeo y devuelve un estéreo. No procesa tele en directo. El código está abierto en SourceForge y en GitHub.
Para terminar
Desde el lado del audio, lo interesante no es el resultado —que aún está por medir— sino la postura: separar, tratar y reunir sin destrozar la mezcla. Al final, la pregunta que cualquier ingeniero se haría al escuchar el resultado sigue siendo la misma: ¿se entiende mejor, y cuánto me he llevado por delante de la naturalidad?